

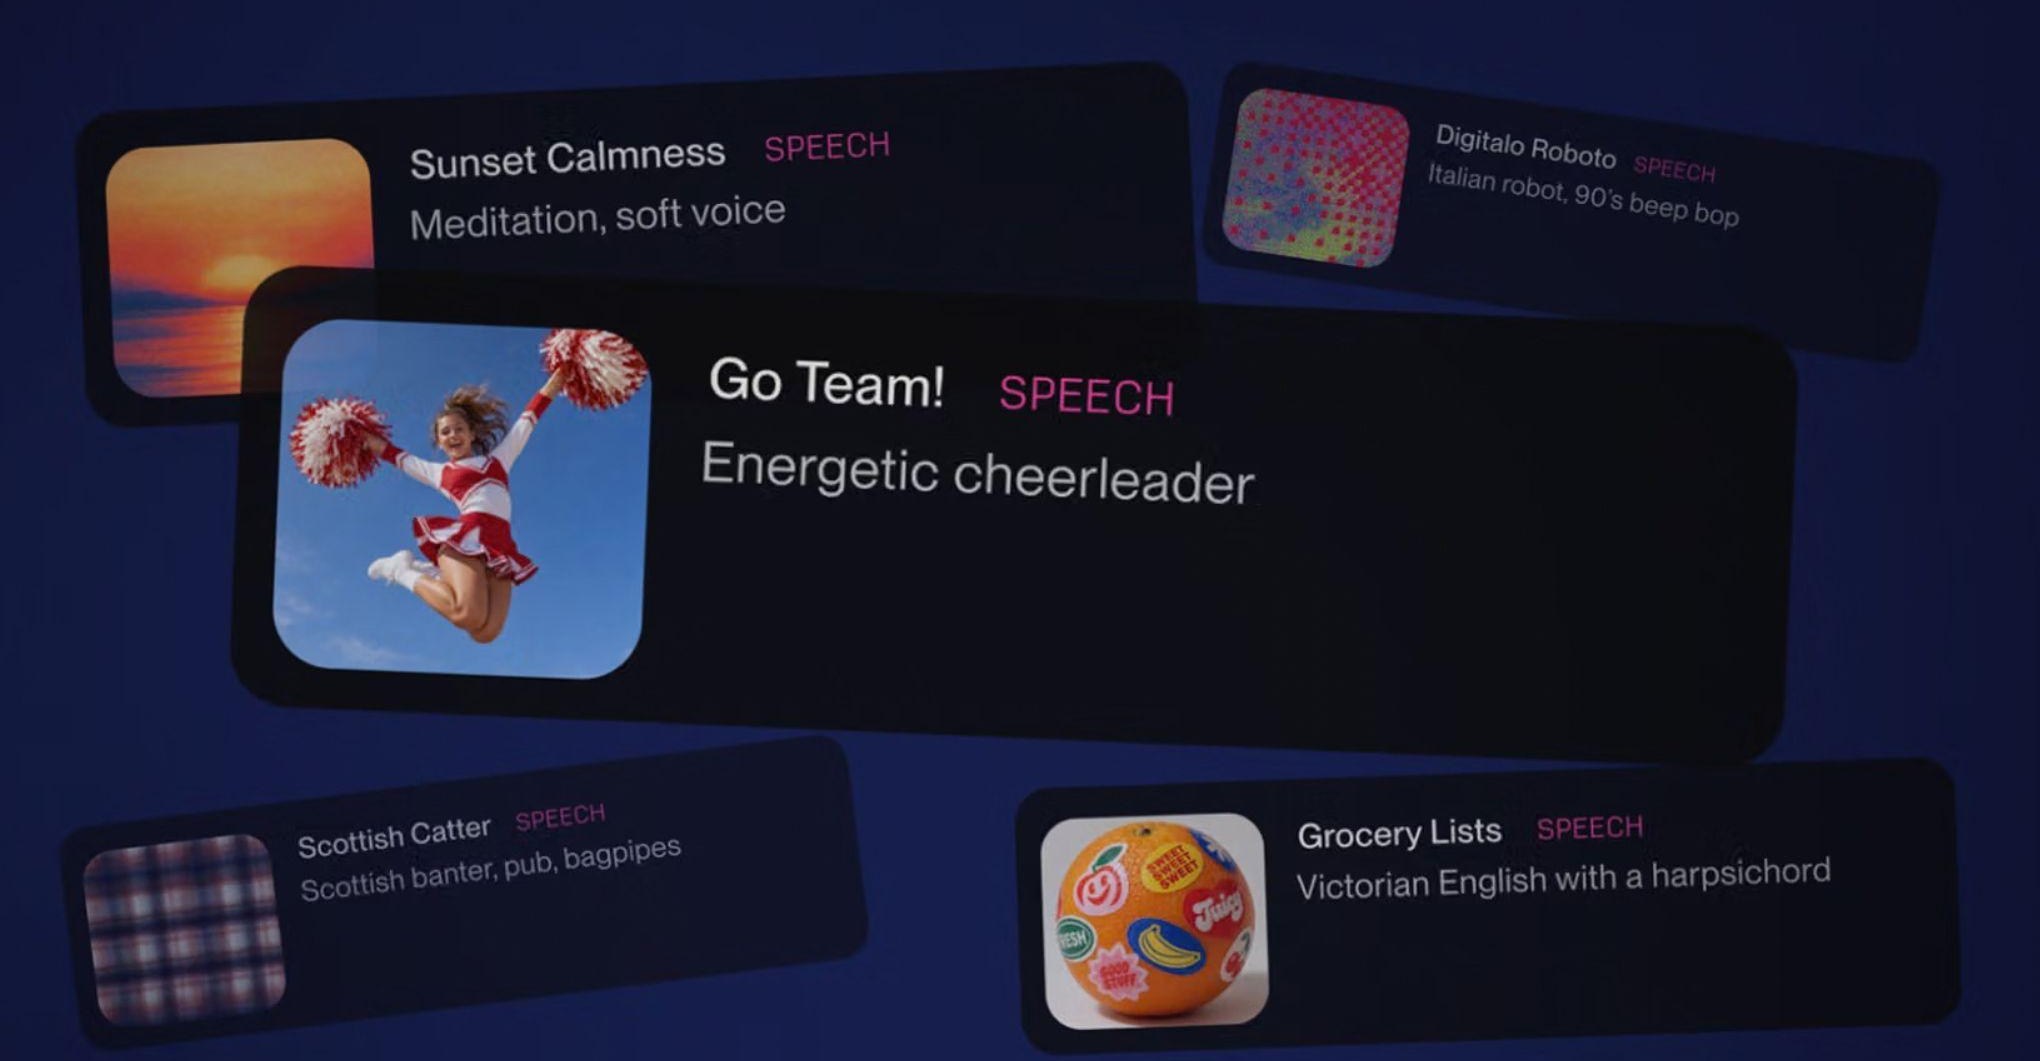
Suno har lanserat Speech, en betafunktion som är öppen för allmänheten och genererar talat ljud från ett manus eller en skriftlig beskrivning. Funktionen finns på Sunos webb- och mobilplattformar och kan skapa en speakertext tillsammans med bakgrundsmusik i ett och samma spår.
Musiken är valfri och kan stängas av. Suno beskriver funktionen som ett sätt att kombinera tal med passande ljudspår, till exempel lugn musik till dikter eller mer energisk musik till dramatiska speakertexter och uppmuntrande tal.
Användare hittar Speech under fliken Create. Läget Simple skapar ljud utifrån en beskrivning, medan Advanced tar emot ett eget manus. I Advanced går det också att justera AI-röstens kön och talstil samt hur stor variation varje generering ska ha. Speech kan vara i upp till cirka åtta minuter.
Sunos produktchef Jack Brody beskrev Speech som företagets första ljudmodell som genererar röst och musik tillsammans. AI-baserad talgenerering finns redan hos andra företag: DeepMind har arbetat med talsyntes i ett decennium, Adobe har ett text-till-tal-verktyg och ElevenLabs lanserades 2023.
Suno säger att företaget fortsätter att förbättra Speech utifrån användarnas synpunkter. Brody medgav att betaversionens accenter ibland kan bli inkonsekventa och att pauserna kan bli överdrivet dramatiska. The Verge rapporterar att Sunos musikgenerator har varit föremål för stämningar; i tillkännagivandet står det inte att Speech är ett svar på dem.
Kommentarer
0Inga kommentarer ännu. Skriv den första.