

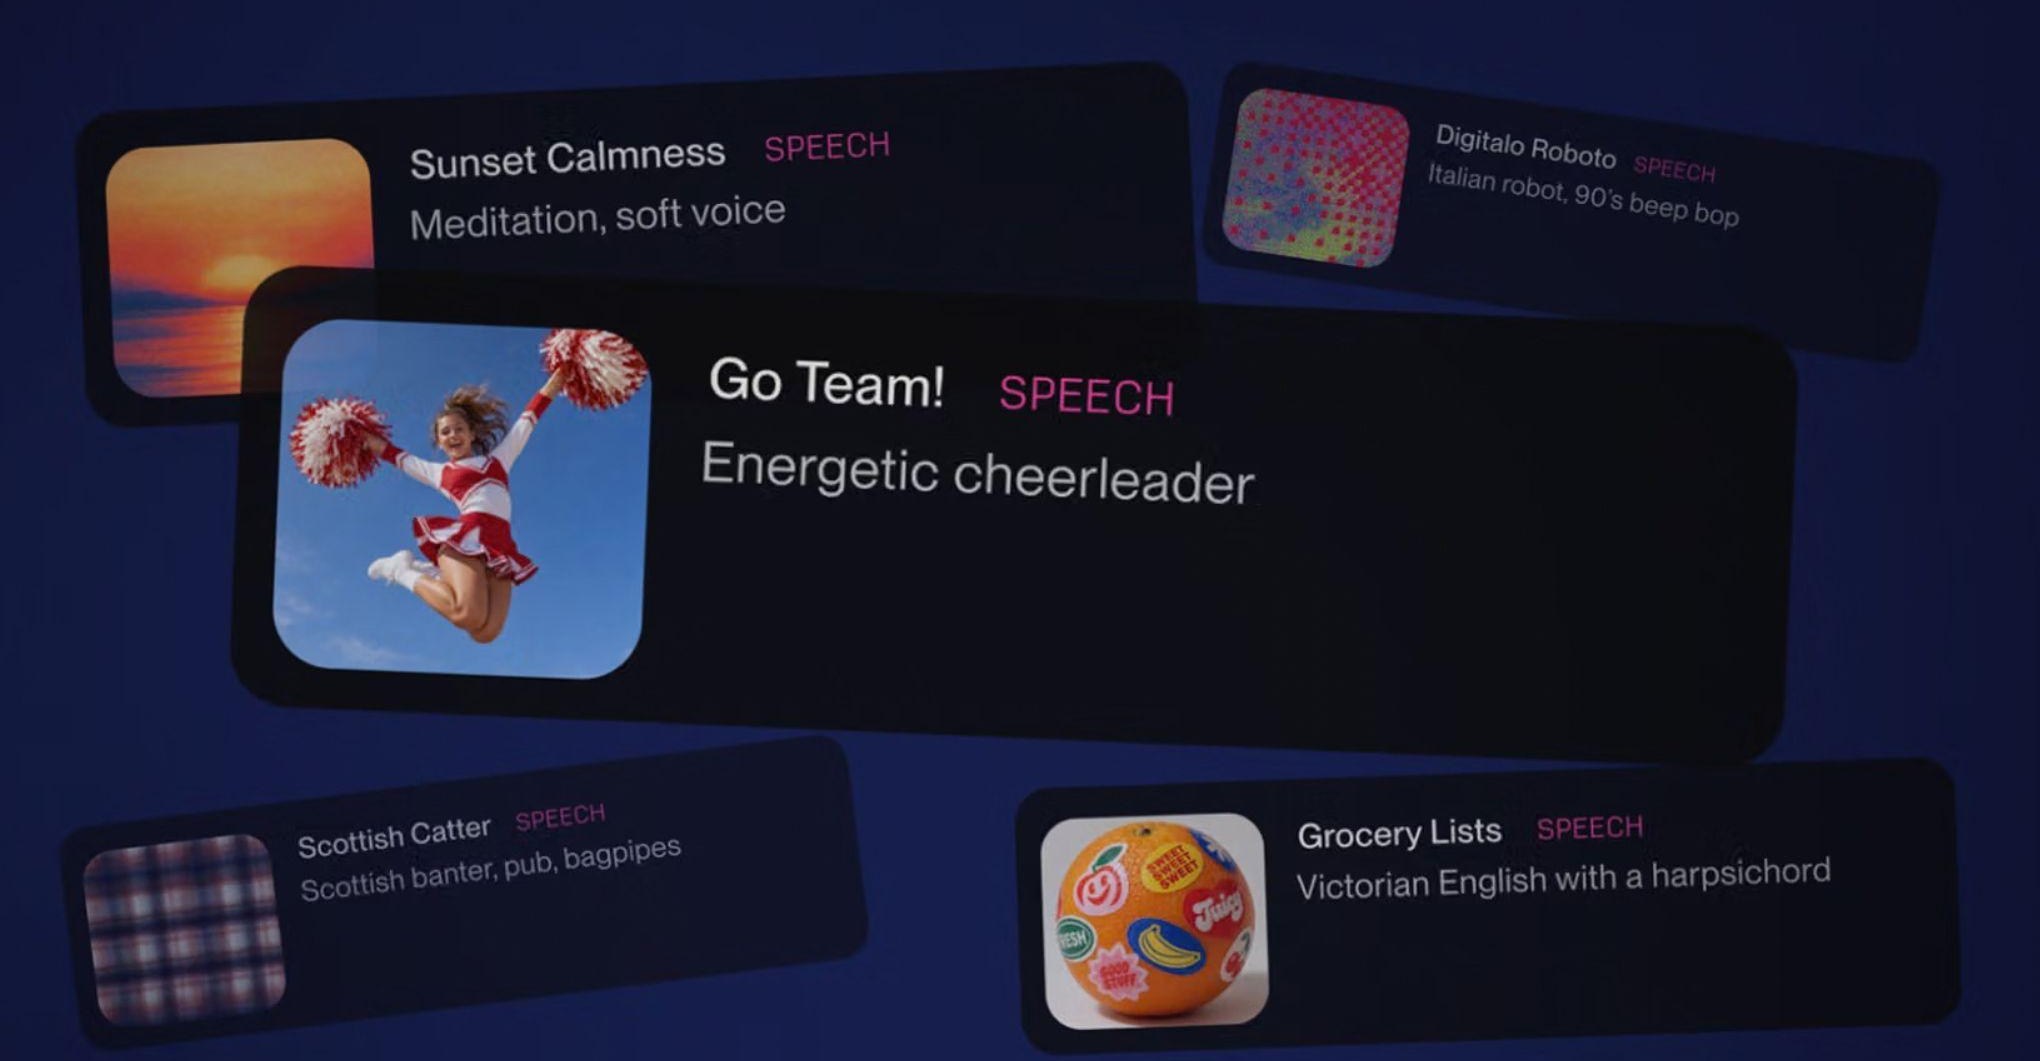
Suno ha lanzado Speech, una función en beta pública que genera audio hablado a partir de un guion o una descripción escrita. Está disponible en las plataformas web y móvil de Suno y puede generar una locución junto con música de fondo en una sola pista.
La música es opcional y se puede desactivar. Suno presenta la función como una forma de acompañar el habla con música adecuada, por ejemplo, una melodía tranquila para poemas o un fondo más enérgico para locuciones dramáticas y discursos motivadores.
Los usuarios pueden encontrar Speech en la pestaña Create. El modo Simple genera audio a partir de una descripción, mientras que Advanced permite introducir un guion propio. Advanced también ofrece ajustes para el género y el estilo de habla de la voz, además del nivel de variación de cada generación. Speech puede durar hasta unos ocho minutos.
Jack Brody, director de producto de Suno, describió Speech como el primer modelo de audio de la empresa que genera voz y música juntas. Otras empresas ya ofrecen generación de voz con IA: DeepMind lleva una década trabajando en síntesis de voz, Adobe tiene una herramienta de texto a voz y ElevenLabs se lanzó en 2023.
Suno afirma que seguirá mejorando Speech a partir de los comentarios de los usuarios. Brody reconoció que las voces de la beta pueden tener acentos inconsistentes y pausas demasiado dramáticas. The Verge informa de que el generador musical de Suno ha sido objeto de demandas; el anuncio no dice que Speech sea una respuesta a ellas.
Comentarios
0Aún no hay comentarios. Escribe el primero.