

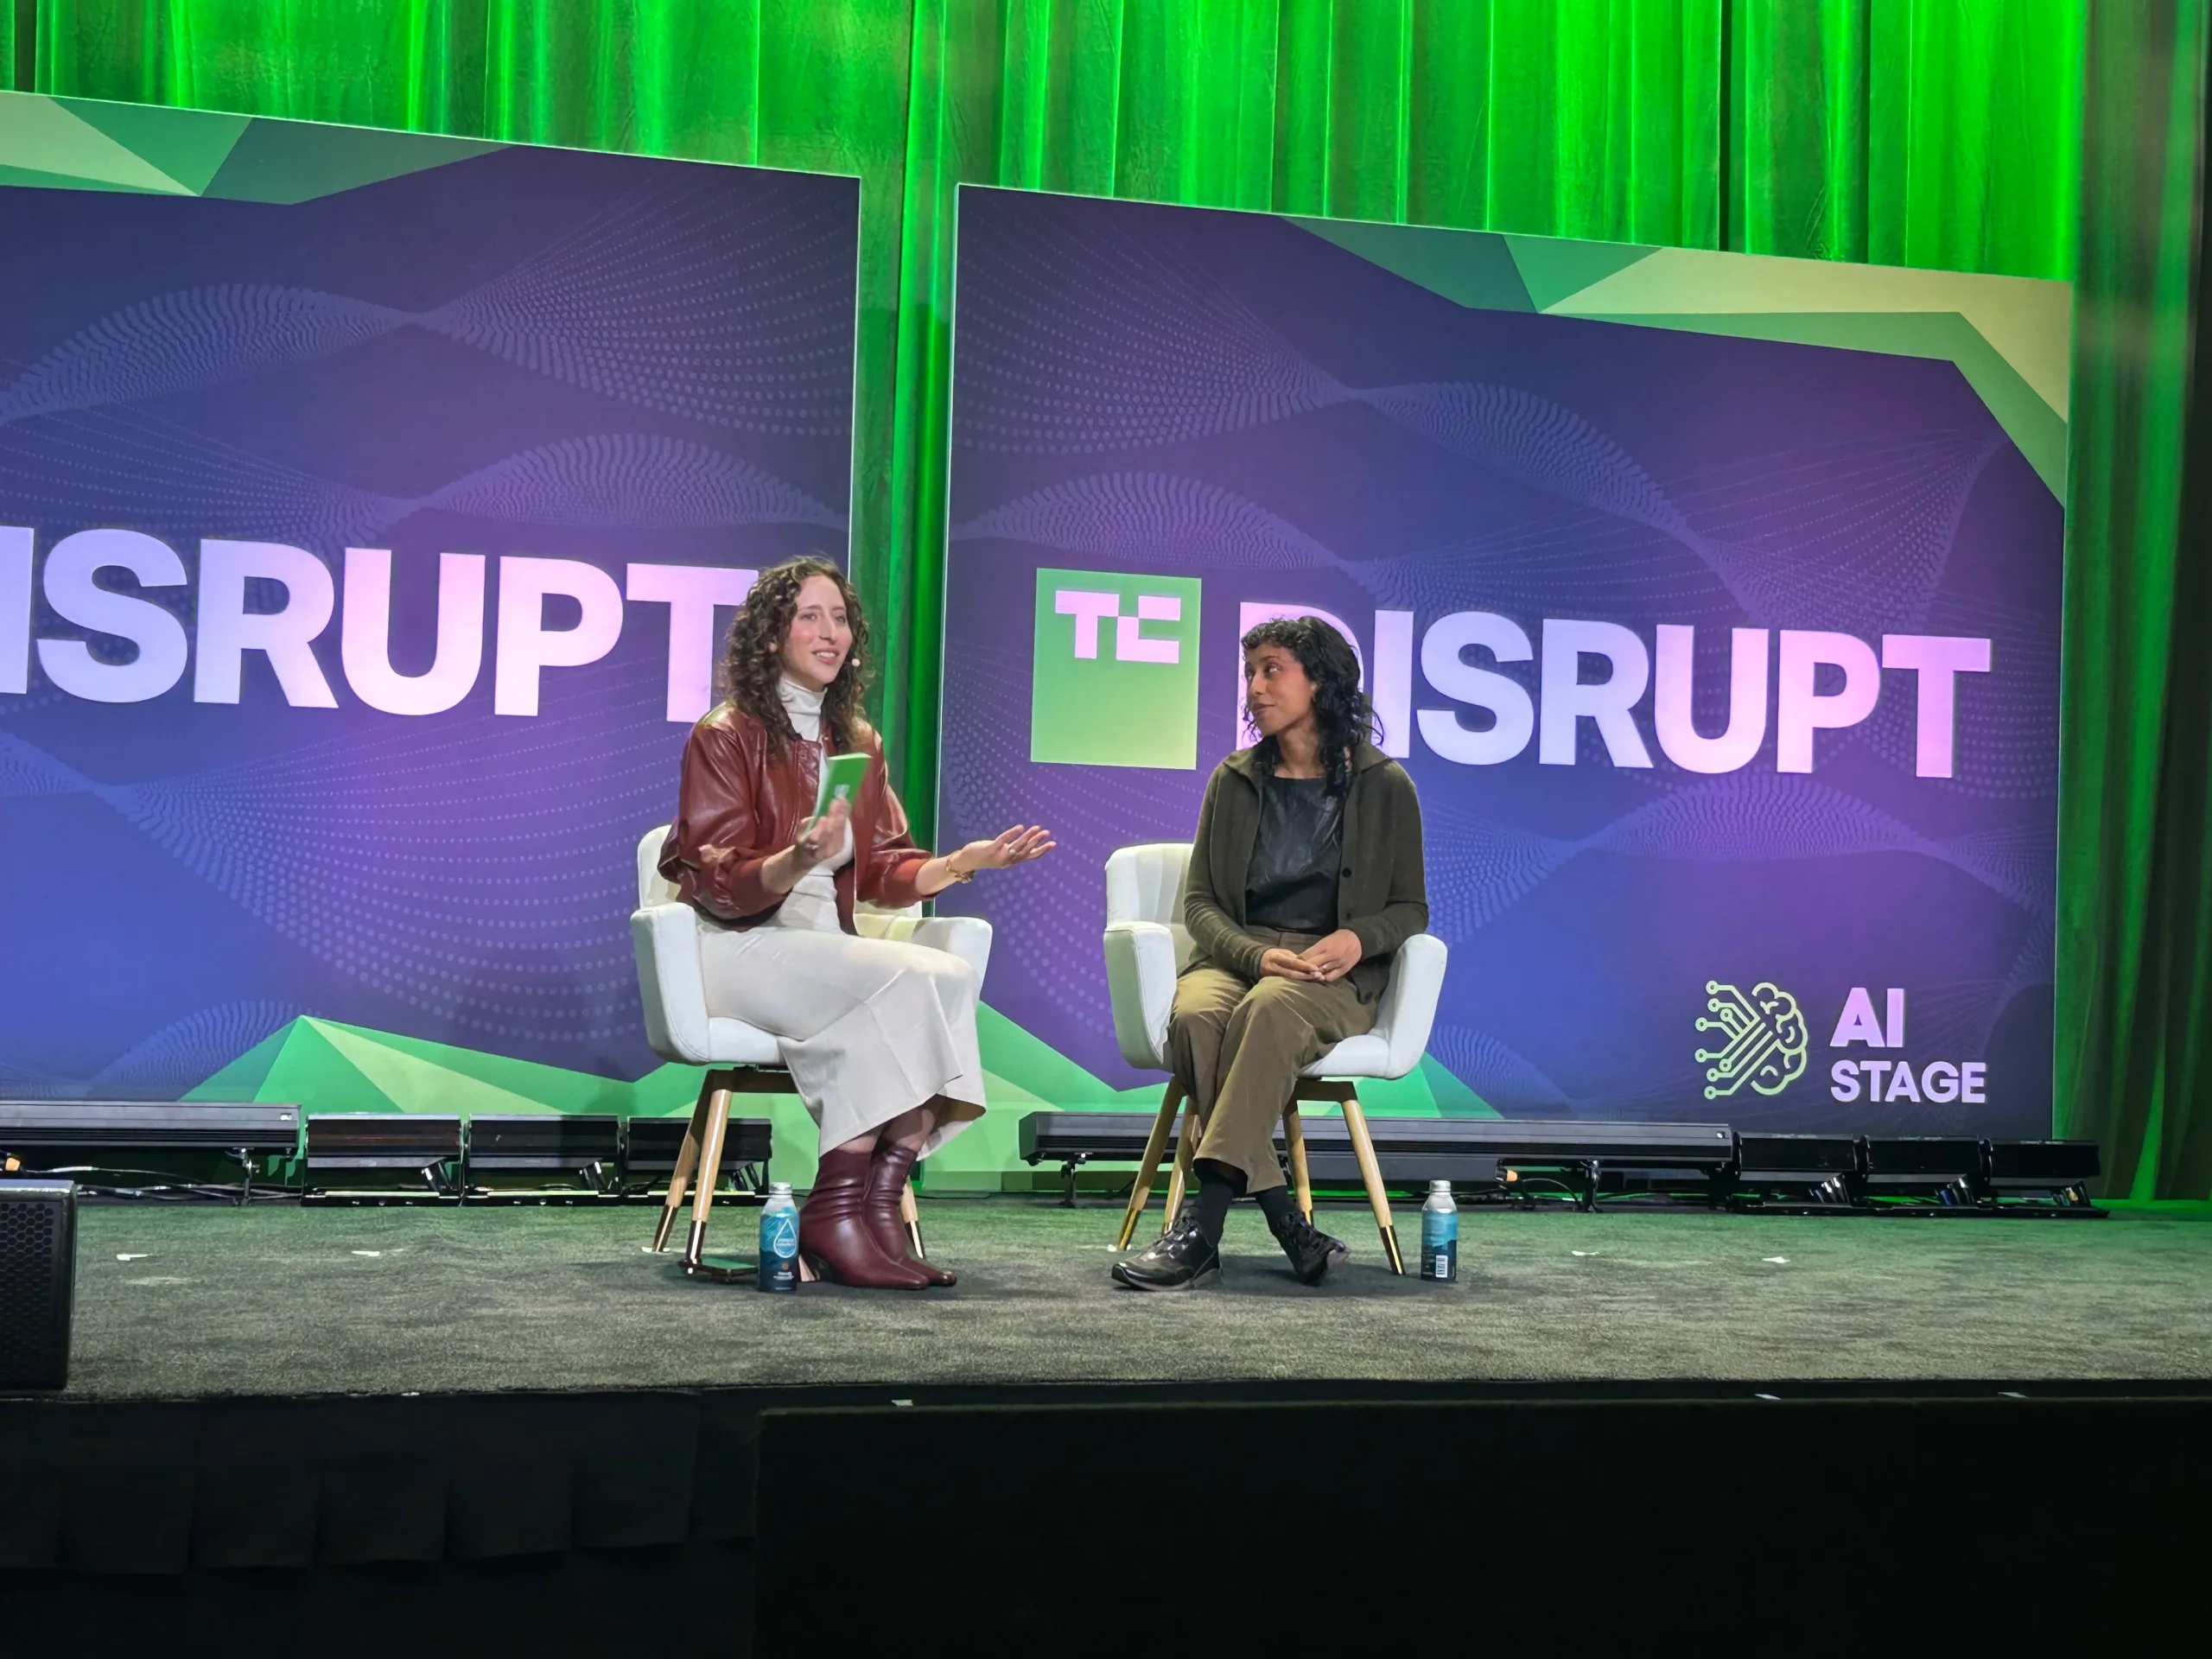
Yapay zekâ şirketleri modelleri karşılaştırmak için kıyaslamalara başvuruyor. Ancak Hugging Face’in politika yöneticisi Irene Solaiman, geçen hafta TechCrunch Disrupt’ta yaptığı konuşmada bu testlerin arkasındaki yöntemlerin karmaşık olduğunu ve hâlâ geliştiğini söyledi.
Solaiman, değerlendirme sonuçlarına güvenin kısmen başkalarının testleri tekrarlayıp tekrarlayamadığına ve modele yeterince erişip erişemediğine bağlı olduğunu belirtti. Açık ağırlıkların bu erişimi destekleyebileceğini söyledi. Ayrıca değerlendirmelerin birbiriyle karşılaştırılmasının zor olduğunu, kısa sürede etkisizleşebildiğini ve daha fazla standardizasyona ihtiyaç duyduğunu ifade etti.
Bu tartışma, yapay zekâ laboratuvarlarının güvenlik olaylarının ardından incelemelerle karşılaştığı ve gömülü değerlendirmecileri öne çıkardığı bir dönemde yaşanıyor. Bunlar, yapay zekâ kuruluşlarının içine yerleştirilen ve tarafsız olduğu varsayılan üçüncü taraf gözlemciler. Solaiman, değerlendirmecilerin farklı görevler için hangi niteliklere sahip olması gerektiğinin daha açık standartlara bağlanması gerektiğini söyledi. Anthropic’in ilk değerlendirmecisi olarak Accenture’ı seçmesi, şirketin yeterliliğini sorgulayanların eleştirilerine yol açtı.
Değerlendirmeler artık modellerin yanı sıra kullanıcıların erişim için kullandığı araç düzeneklerini ve yapay zekâ ajanlarını da kapsıyor. Solaiman, daha iyi bir araç düzeneğinin daha zayıf bir modelin öncü bir modeli geçmesine yardımcı olabileceğini söyledi. Ajan değerlendirmelerini zor ve pahalı olarak niteledi; araç düzeneklerine yönelik değerlendirmelerin model değerlendirmelerine kıyasla daha az geliştiğini belirtti. Bütün ajanları kapsayan daha geniş değerlendirmeler üzerinde çalışıldığını da söyledi.
Yorumlar
0Henüz yorum yok. İlk yorumu siz yazın.