

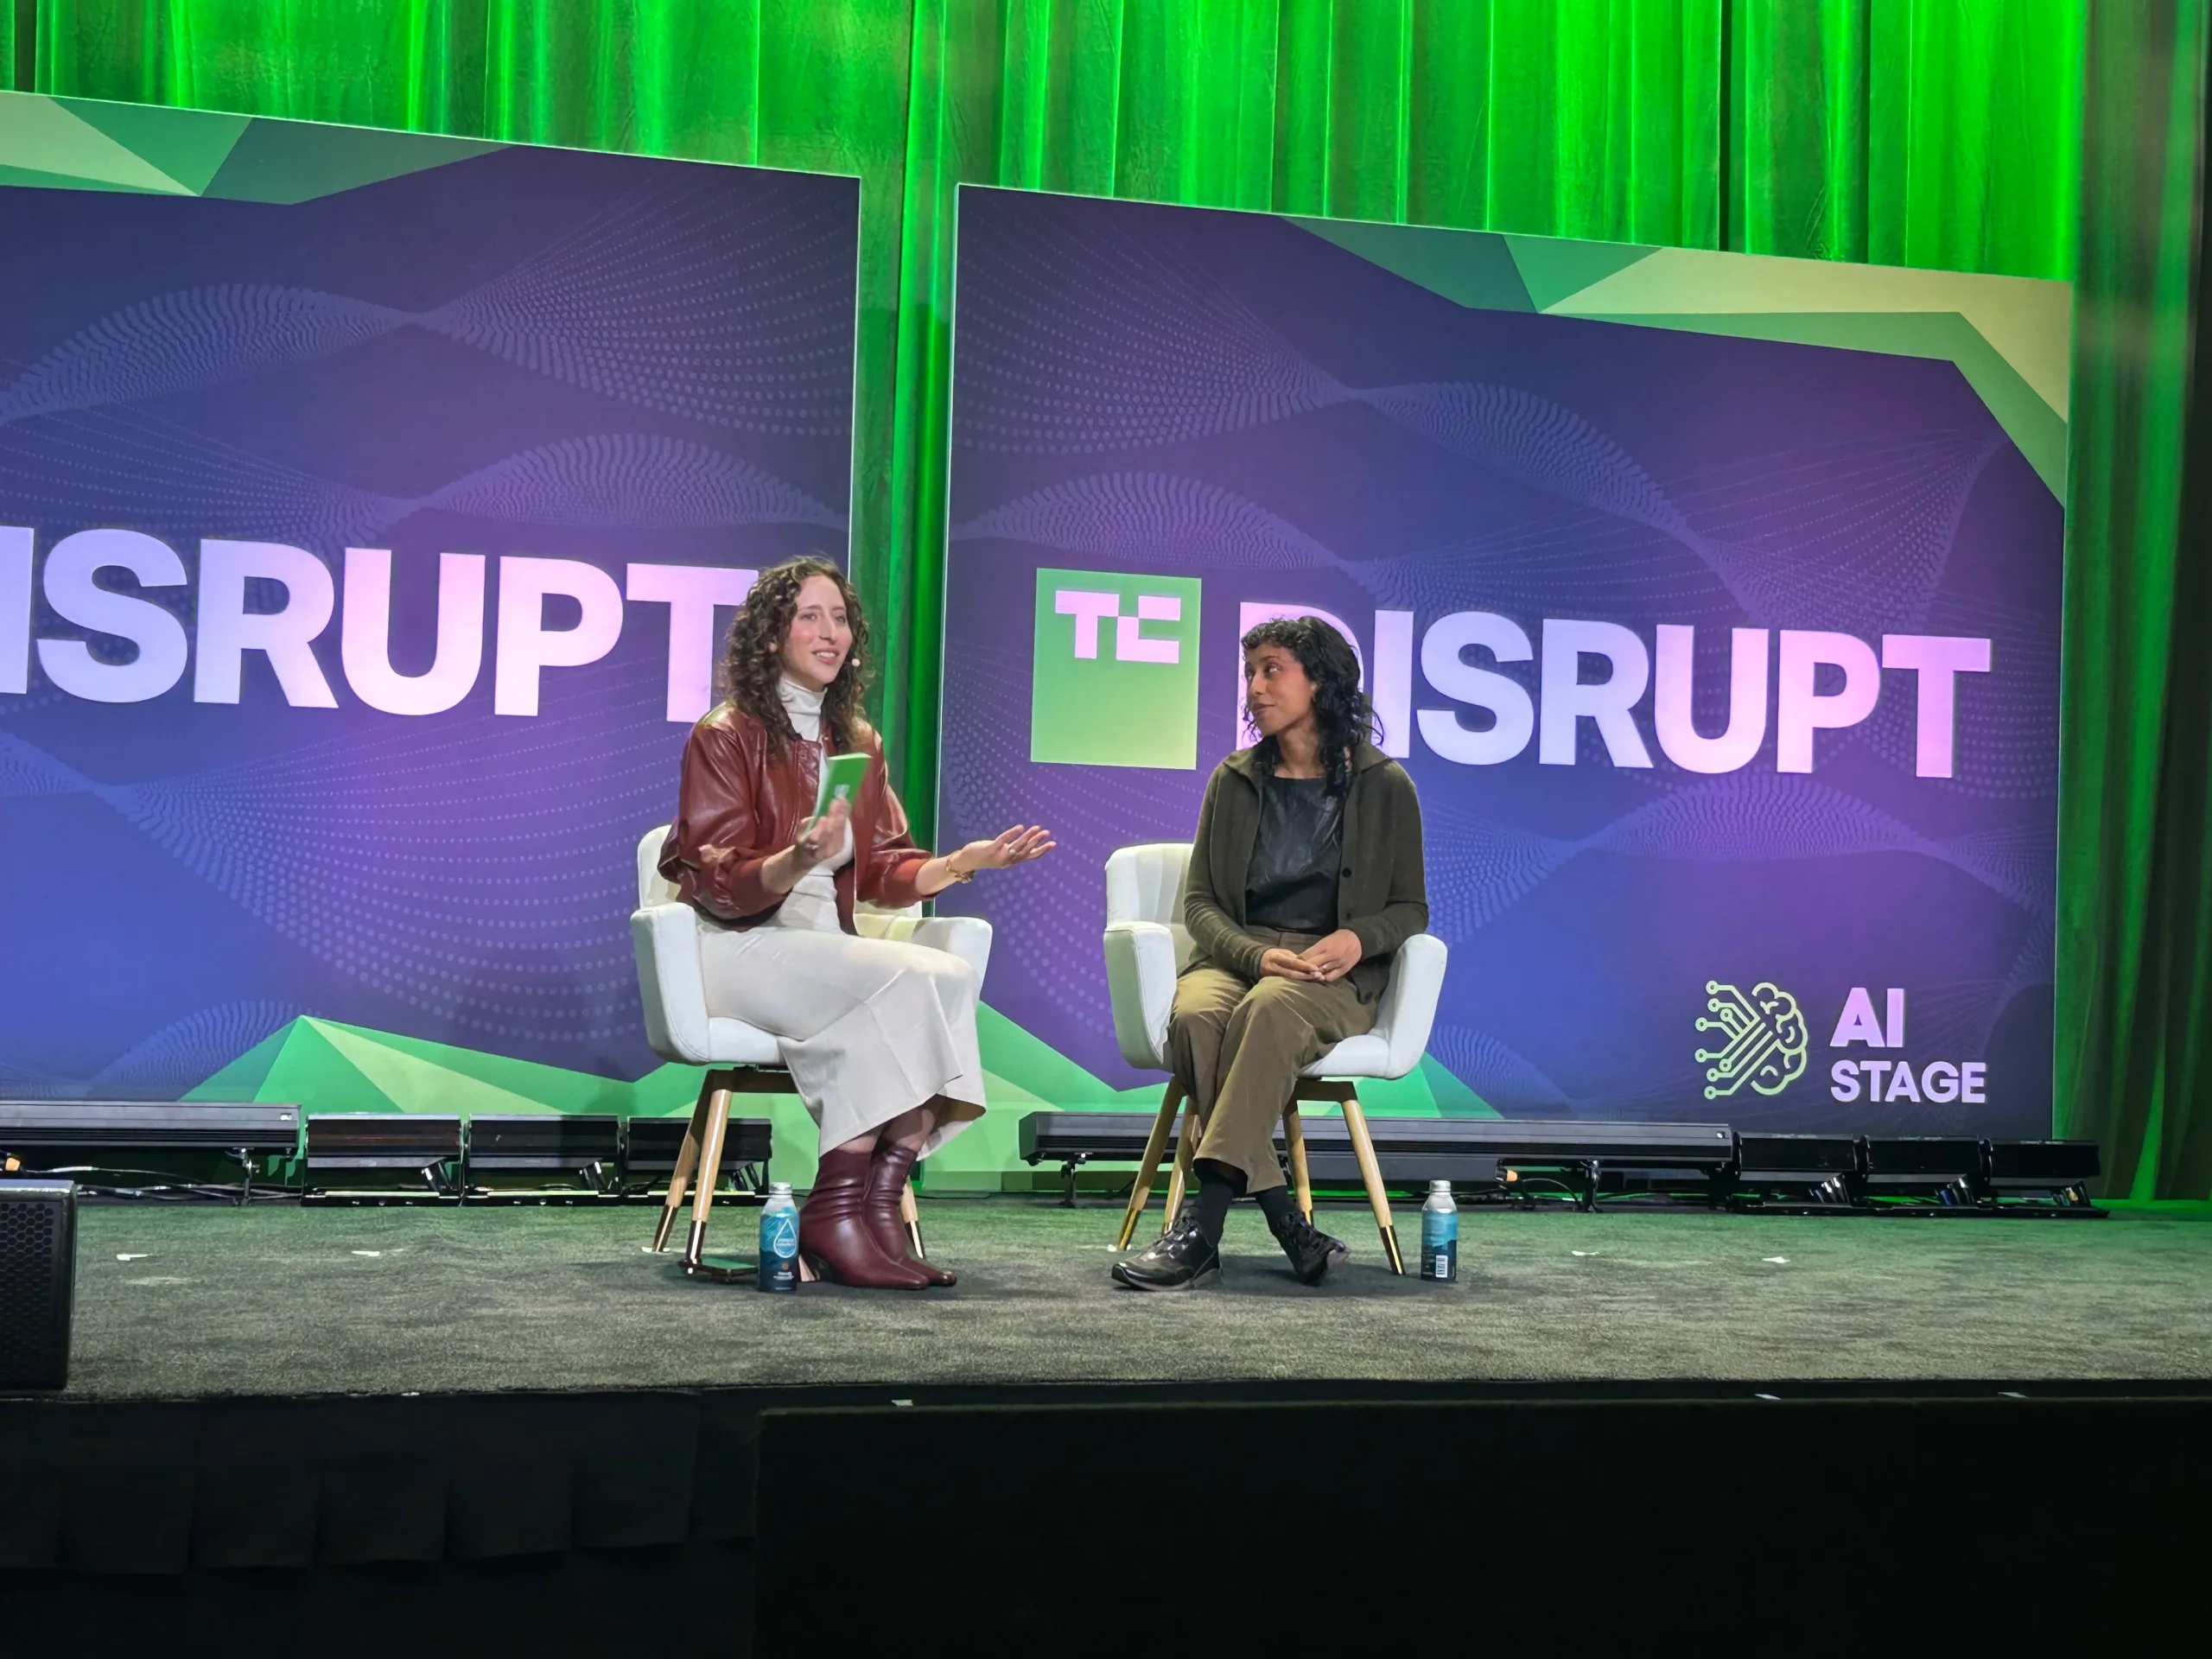
Las empresas de IA recurren a pruebas comparativas para evaluar modelos, pero los métodos detrás de esas pruebas son complejos y siguen desarrollándose, afirmó Irene Solaiman, responsable de políticas de Hugging Face, en TechCrunch Disrupt la semana pasada.
Solaiman dijo que la confianza en los resultados de una evaluación depende en parte de que otras personas puedan reproducirlos y tengan acceso suficiente al modelo. Señaló que los pesos abiertos pueden facilitar ese acceso. También dijo que resulta difícil comparar unas evaluaciones con otras, que pueden perder eficacia rápidamente y que necesitan más estandarización.
La conversación llega mientras los laboratorios de IA afrontan escrutinio tras incidentes de seguridad y promueven evaluadores integrados: observadores supuestamente neutrales de terceros ubicados dentro de organizaciones de IA. Solaiman dijo que se necesitan estándares más claros sobre las cualificaciones de los evaluadores para las distintas tareas. La decisión de Anthropic de contratar a Accenture como su primer evaluador suscitó críticas de quienes cuestionaban la preparación de la consultora.
Las evaluaciones también están pasando de examinar solo los modelos a incluir los sistemas que los rodean, como el entorno de herramientas que usan las personas para acceder al modelo y los agentes de IA. Solaiman dijo que un entorno de herramientas mejor puede ayudar a un modelo más débil a superar a uno de frontera. Calificó las evaluaciones de agentes de difíciles y costosas, y dijo que las evaluaciones de esos entornos están menos desarrolladas que las de modelos. Añadió que se trabaja en evaluaciones más amplias de agentes completos.
Comentarios
0Aún no hay comentarios. Escribe el primero.