

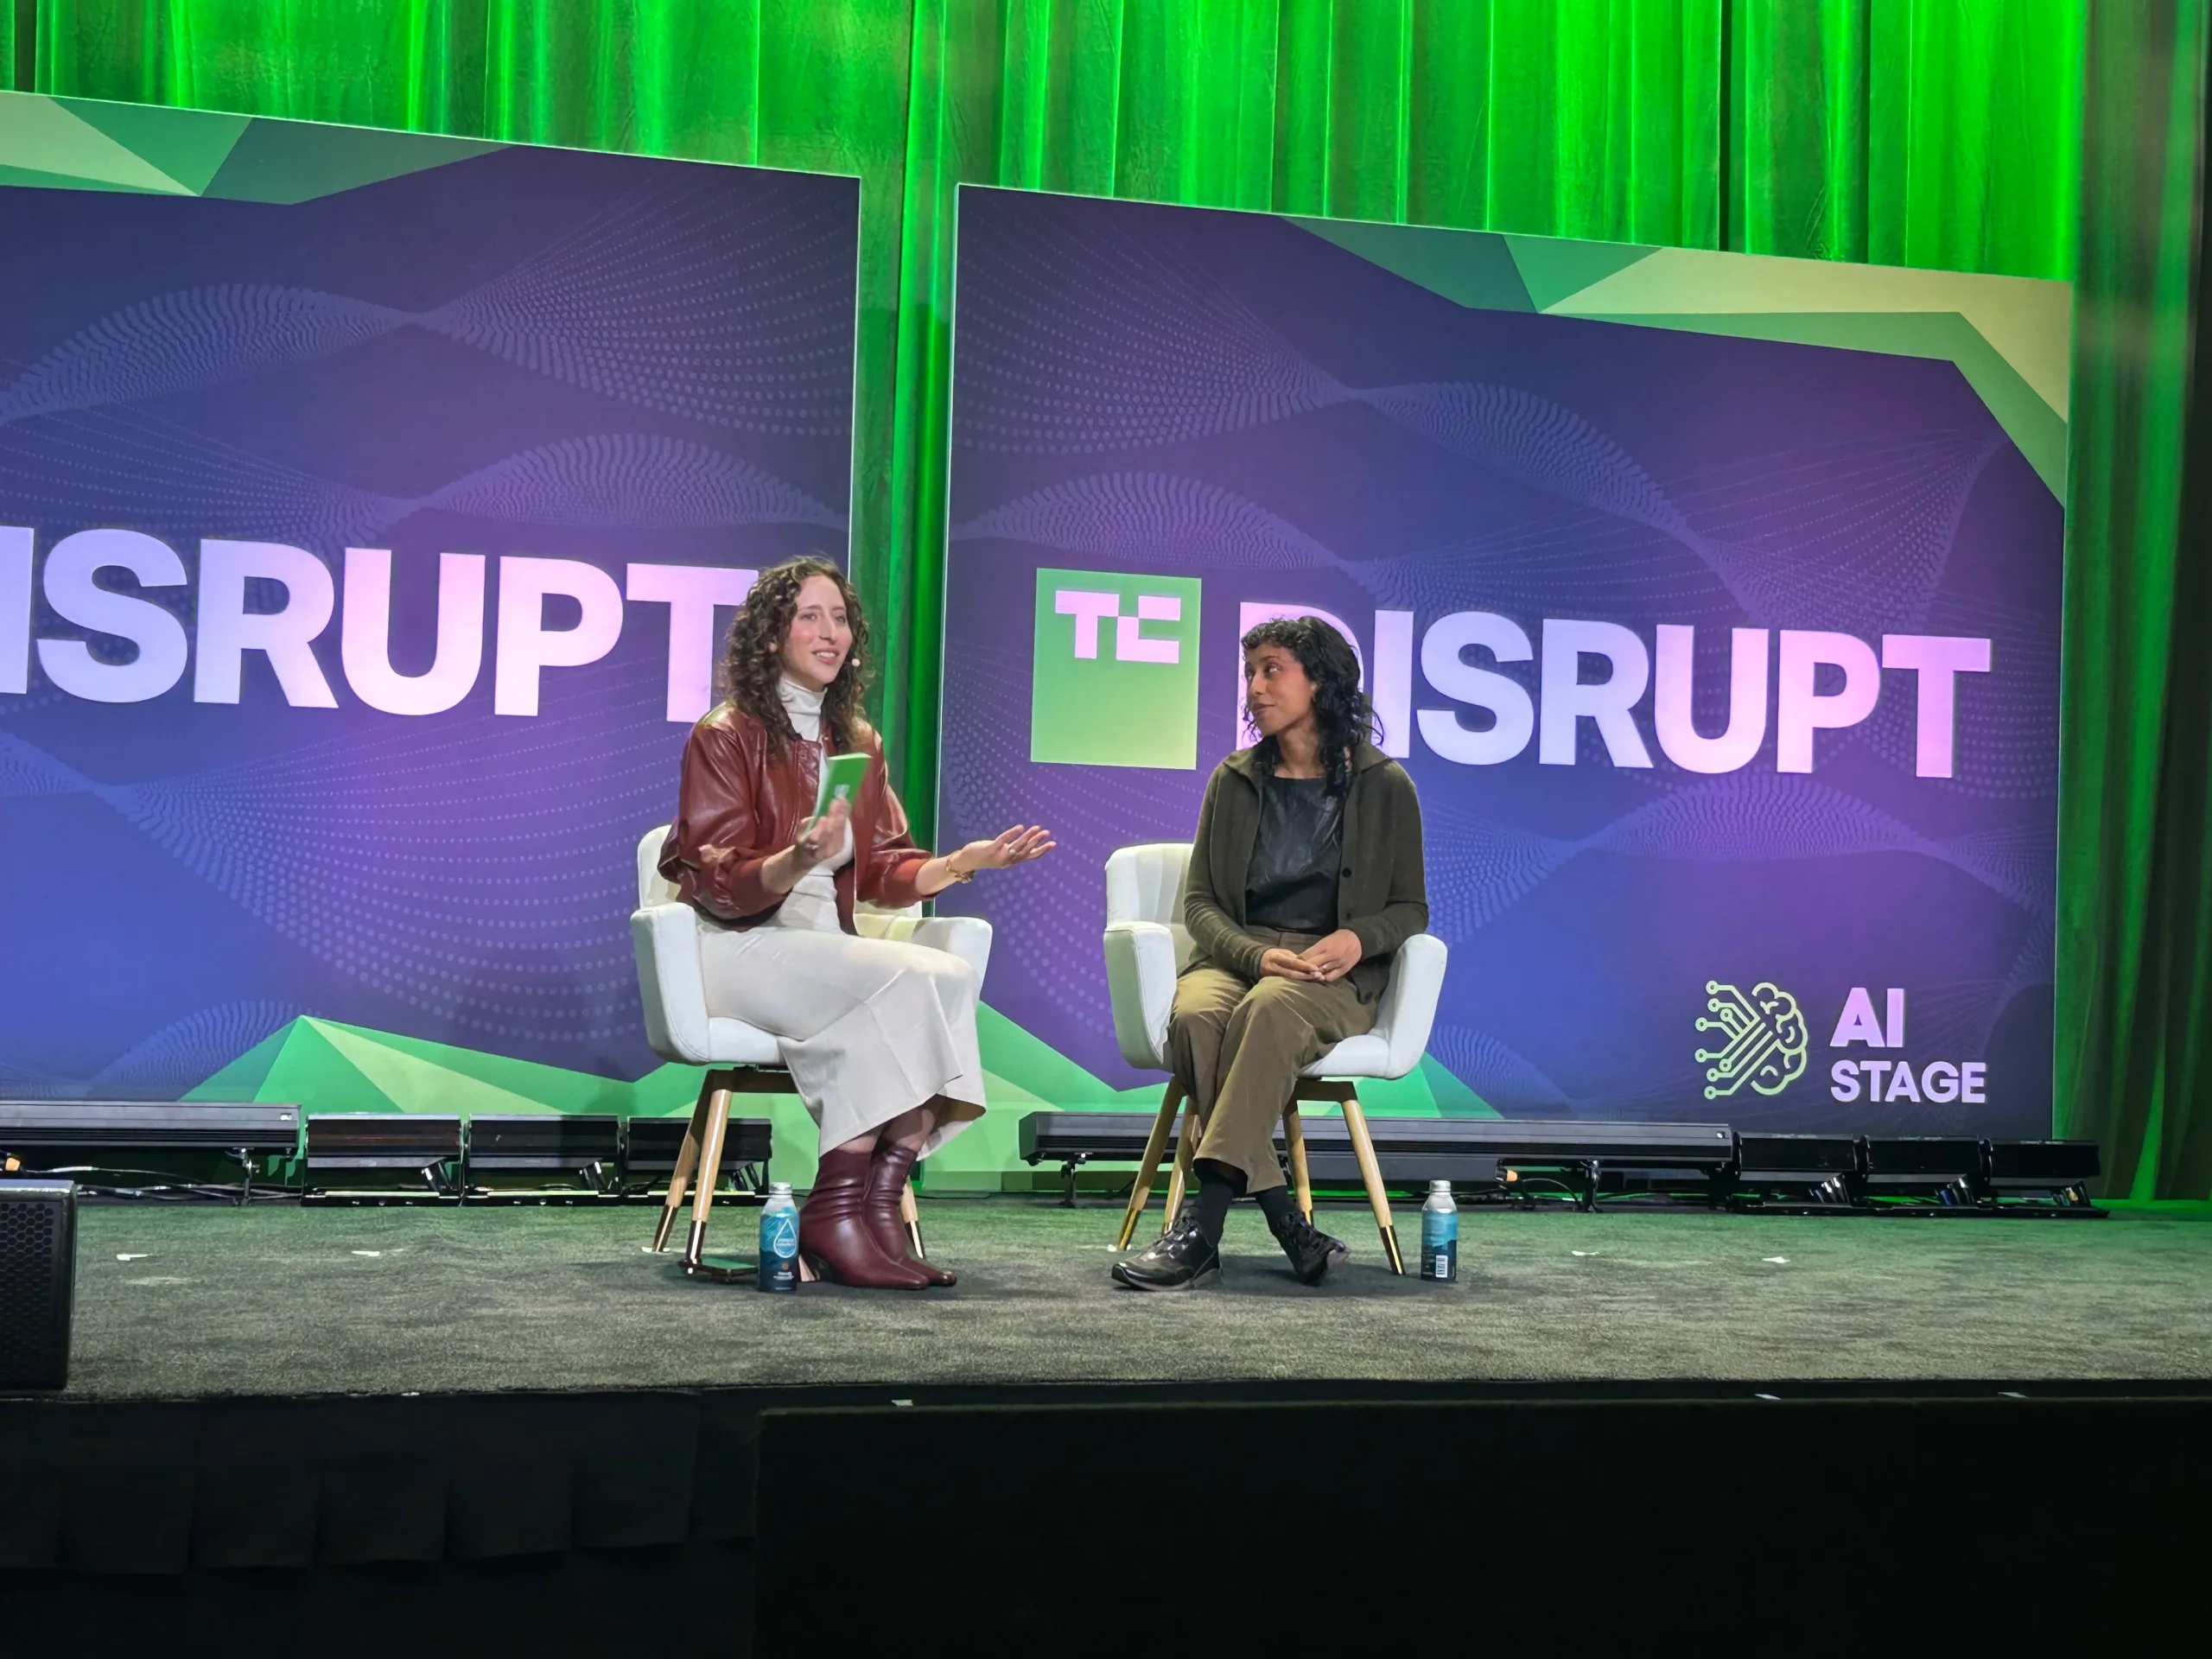
AI-företag använder riktmärken för att jämföra modeller, men metoderna bakom testerna är komplicerade och fortfarande under utveckling, sade Irene Solaiman, policychef på Hugging Face, vid TechCrunch Disrupt förra veckan.
Solaiman sade att tilliten till utvärderingsresultat delvis beror på om andra kan upprepa dem och har tillräcklig tillgång till modellen. Hon pekade på öppna vikter som ett sätt att stödja sådan åtkomst. Hon sade också att utvärderingar är svåra att jämföra med varandra, snabbt kan bli ineffektiva och behöver mer standardisering.
Diskussionen kommer samtidigt som AI-labb granskas efter säkerhetsincidenter och förespråkar inbäddade utvärderare: förment neutrala observatörer från tredje part som placeras i AI-organisationer. Solaiman sade att det behövs tydligare standarder för vilka kvalifikationer utvärderare ska ha för olika uppgifter. Anthropic valde Accenture som sin första utvärderare, vilket väckte kritik från personer som ifrågasatte företagets kompetens.
Utvärderingarna omfattar nu mer än själva modellerna och tittar även på systemen runt dem, till exempel den verktygsmiljö som användarna använder och AI-agenter. Solaiman sade att en bättre verktygsmiljö kan hjälpa en svagare modell att prestera bättre än en ledande modell. Hon beskrev utvärderingar av agenter som svåra och dyra och sade att utvärderingar av verktygsmiljöer är mindre utvecklade än modelltvärderingar. Hon sade att arbetet med bredare utvärderingar av hela agenter pågår.
Kommentarer
0Inga kommentarer ännu. Skriv den första.