

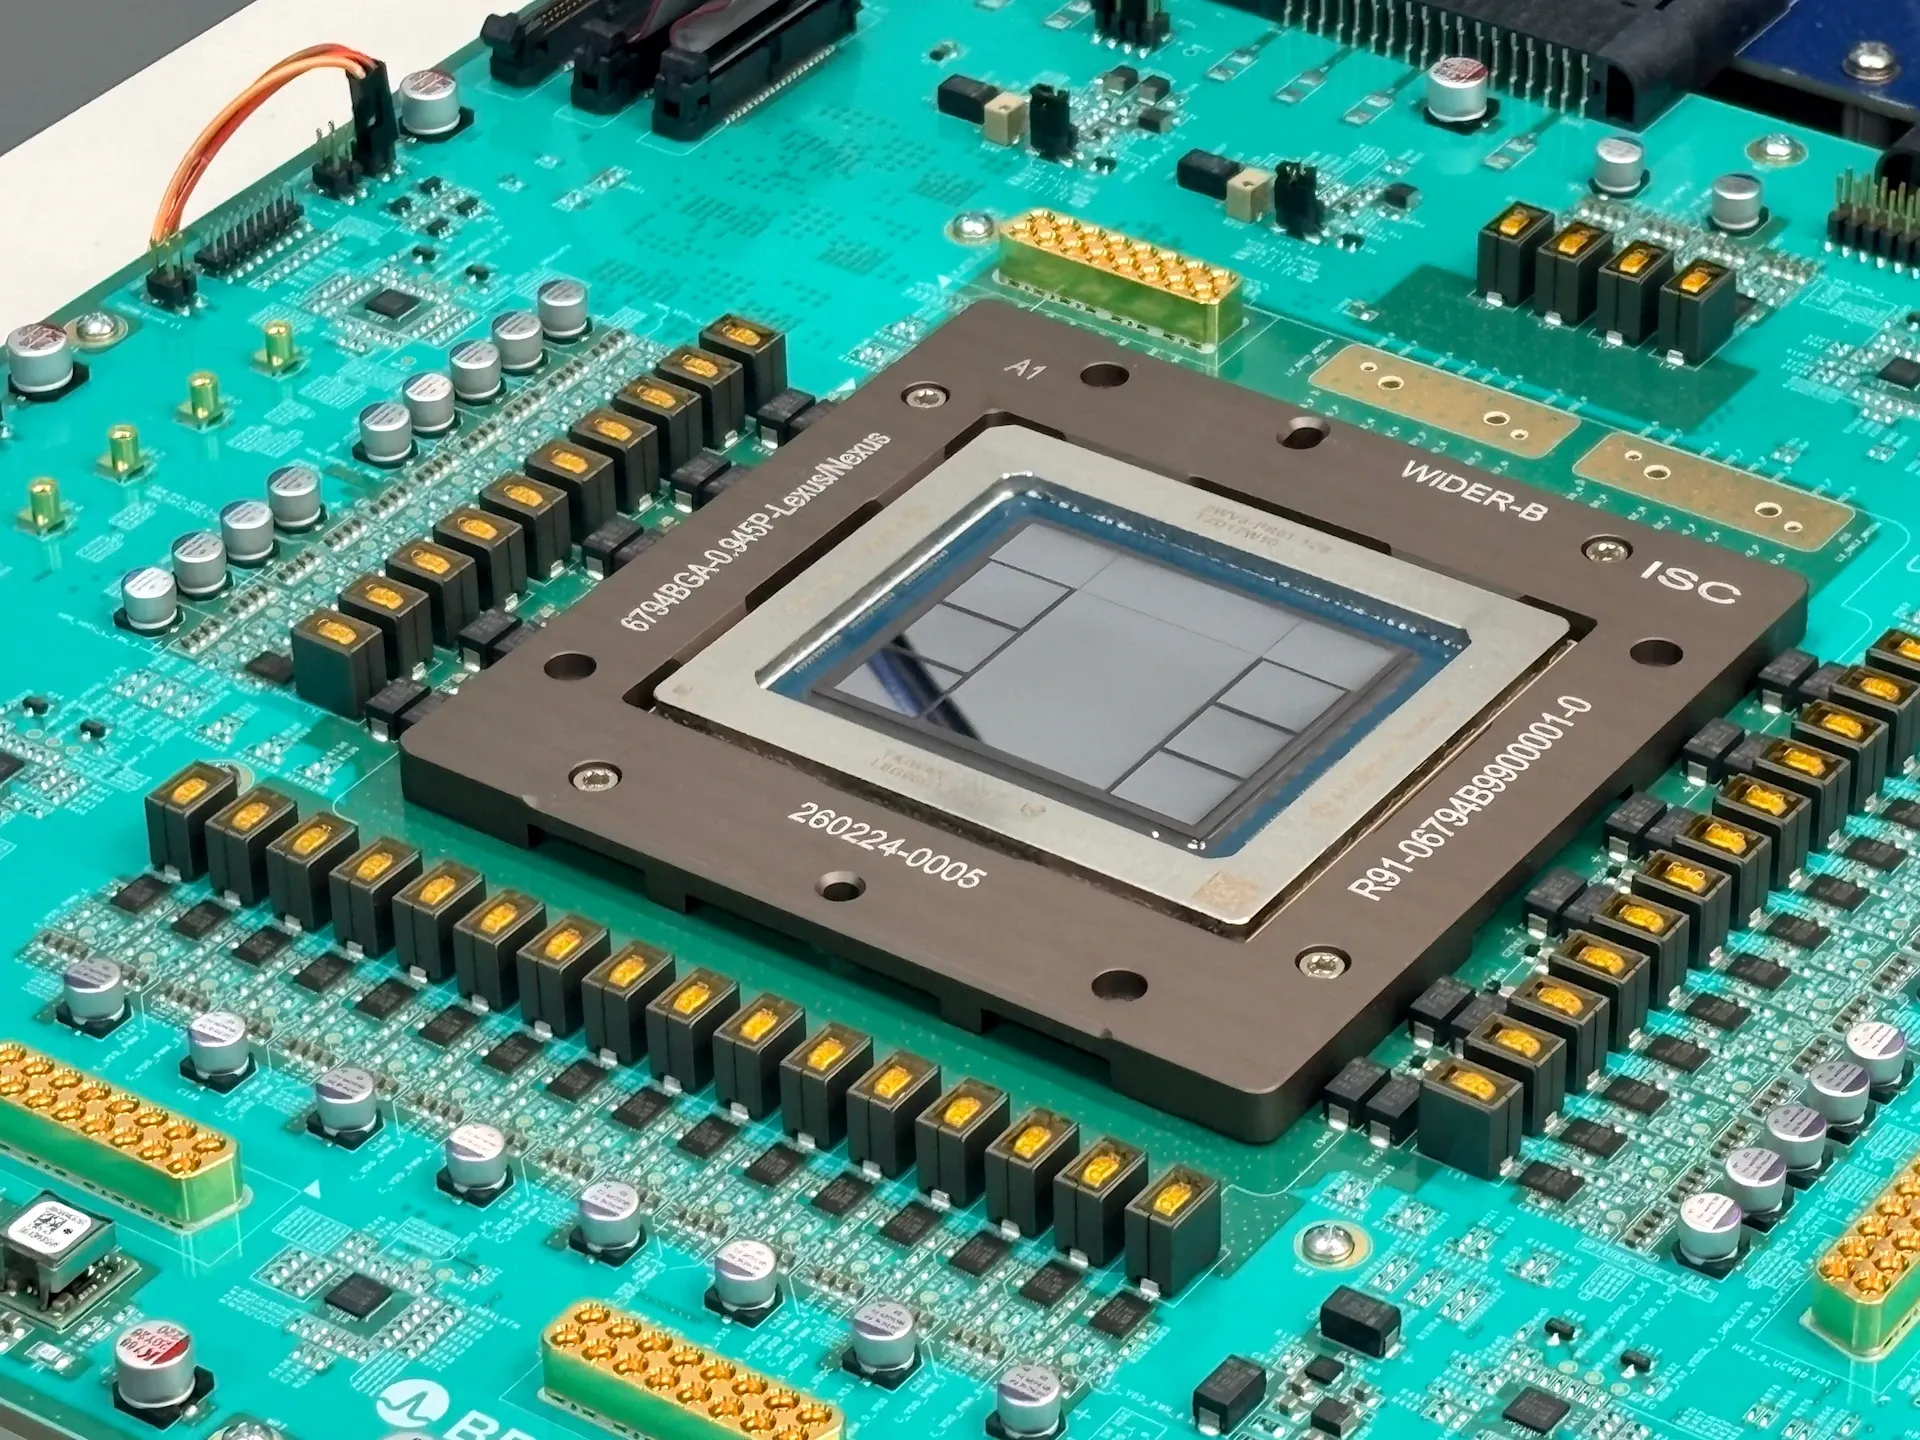
OpenAI har publicerat sina första prestandasiffror för Jalapeño, en inferensaccelerator som utvecklats tillsammans med Broadcom. Företaget presenterade resultaten vid Hot Chips den 25 augusti och fokuserade på effektivitet i stället för en direkt jämförelse med Nvidias Vera Rubin-arkitektur.
I tre öppna modeller rapporterade OpenAI 1,5 till 1,9 gånger högre genomströmning per kilowatt och 1,7 till 3,6 gånger lägre latens från början till slut än de Nvidia-racksystem som testades. Jalapeño är klassad för 700 W, jämfört med 1200 W och 1400 W för Nvidia-systemen.
OpenAI körde SemiAnalysis offentliga InferenceX-testsvit med GPT-OSS 120B, DeepSeek R1 670B och Moonshot AI:s Kimi K2.5 med en biljon parametrar. Företaget rapporterade en effektivitetsfördel på 1,9 gånger mot GB200 för GPT-OSS samt 1,7 respektive 1,5 gånger mot GB300 för de två andra modellerna. Någon jämförelse mellan Jalapeño och GB300 för GPT-OSS 120B publicerades inte.
Siffrorna bygger på förutsägelse av en token i taget, utan speculative decoding och utan prefill-decode disaggregation. I en konfiguration med flera tokens sjunker Jalapeños högsta effektivitetsfördel mot GB300 till ungefär 1,5 gånger. Testerna använder A0-kisel. En B0-stepping med ungefär 25 procent bättre prestanda per watt finns redan i produktion, och produktionen ska öka gradvis under 2027.
Kommentarer
0Inga kommentarer ännu. Skriv den första.