

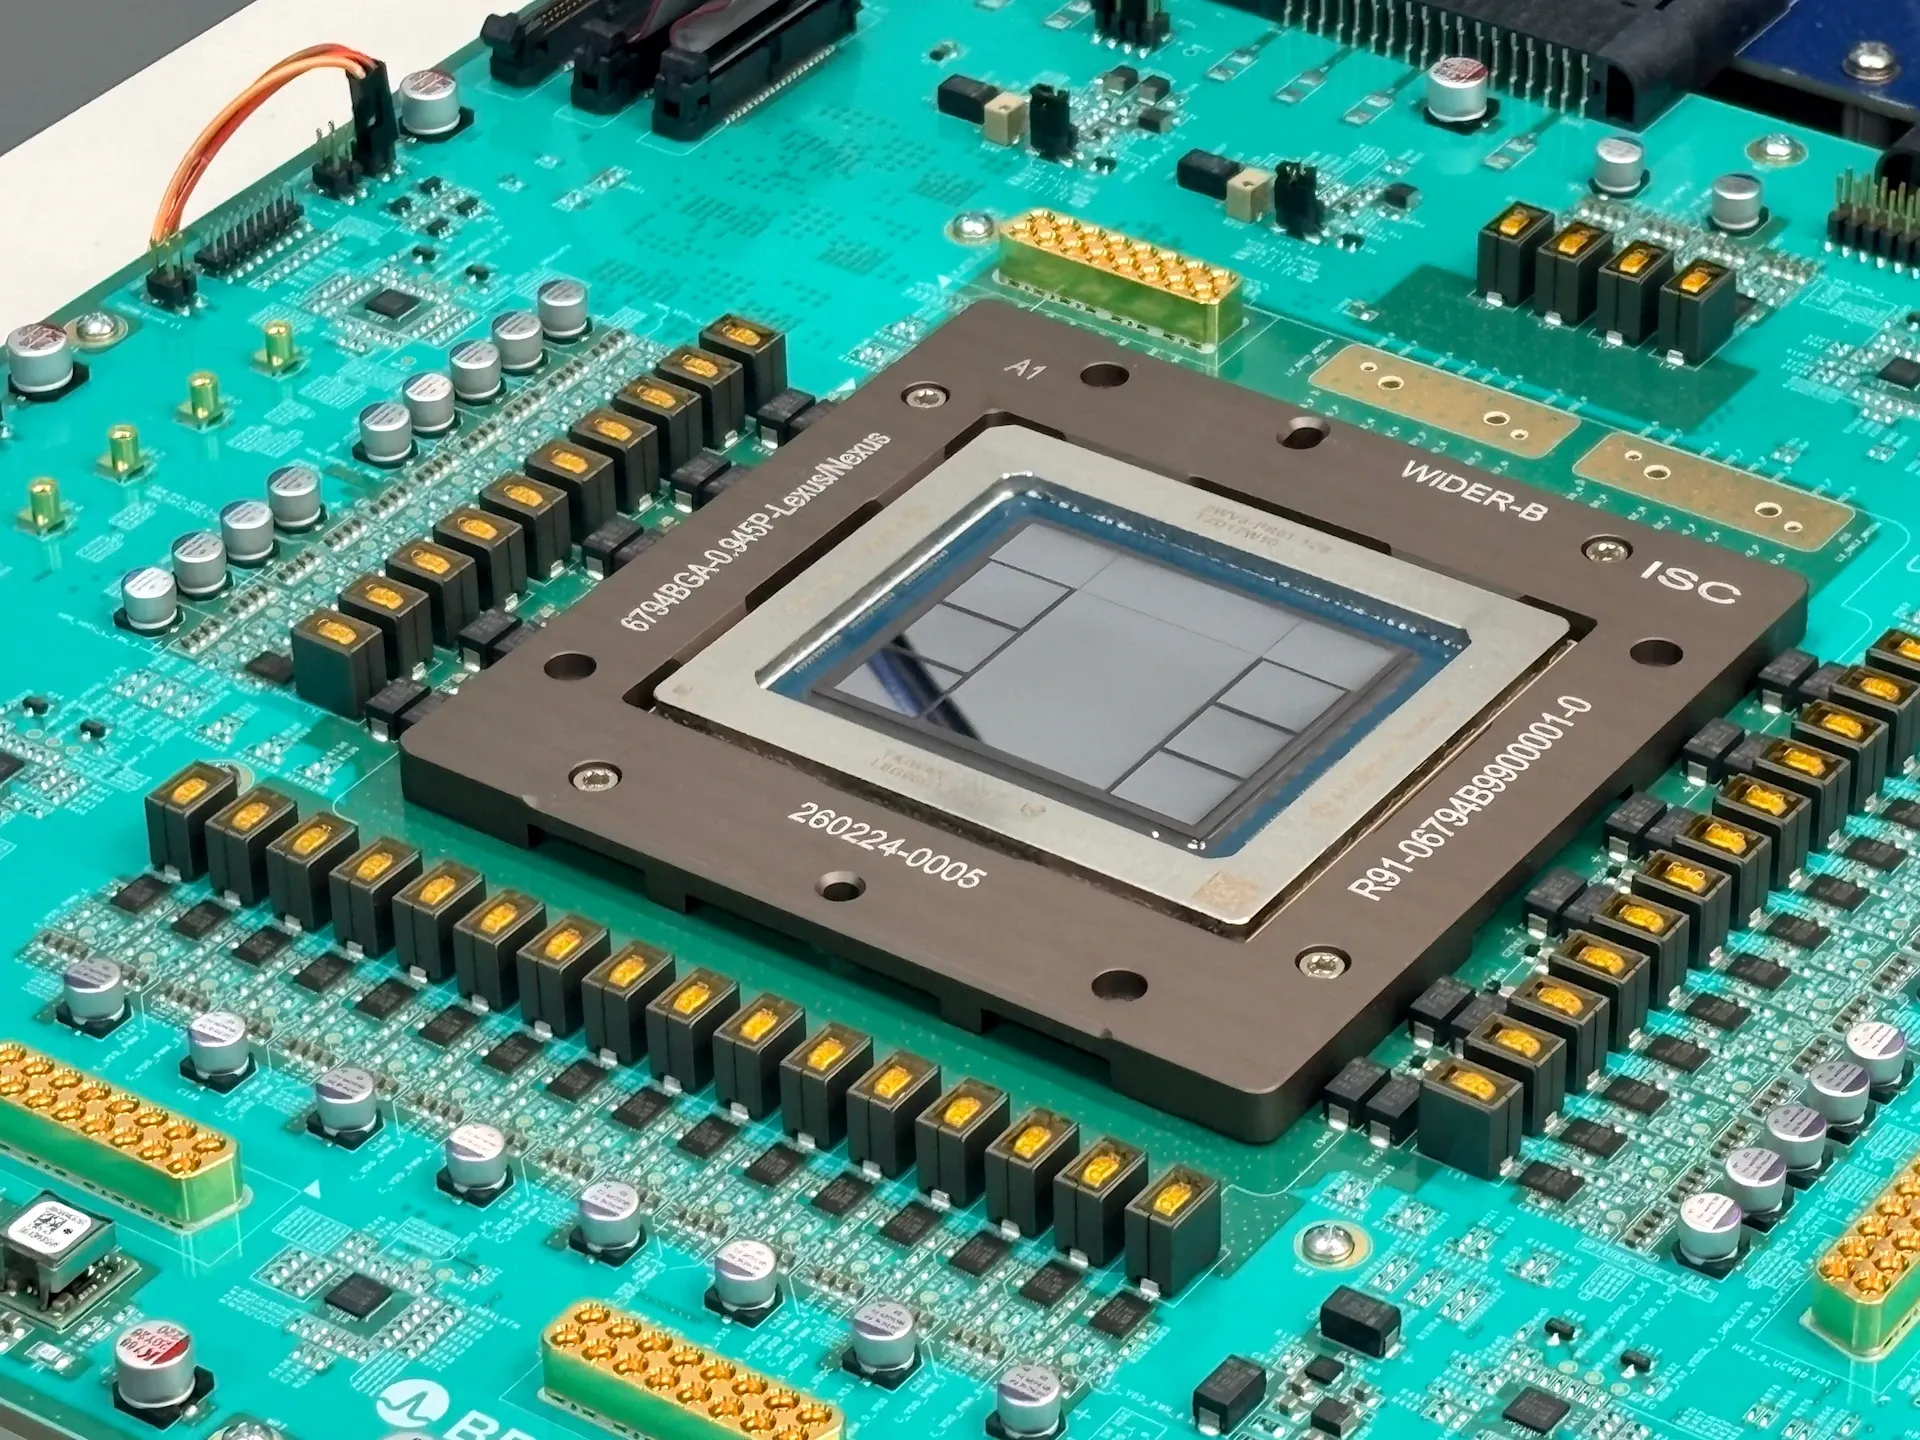
OpenAI ha publicado las primeras cifras de rendimiento de Jalapeño, un acelerador de inferencia desarrollado junto con Broadcom. La empresa presentó los resultados en Hot Chips el 25 de agosto y se centró en la eficiencia, en lugar de ofrecer una comparación directa con la arquitectura Vera Rubin de Nvidia.
En tres modelos abiertos, OpenAI informó de entre 1,5 y 1,9 veces más rendimiento por kilovatio y entre 1,7 y 3,6 veces menos latencia de extremo a extremo que los sistemas en rack de Nvidia utilizados en las pruebas. Jalapeño tiene una potencia nominal de 700 W, frente a 1200 W y 1400 W en los sistemas de Nvidia.
OpenAI ejecutó el conjunto público de pruebas InferenceX de SemiAnalysis con GPT-OSS 120B, DeepSeek R1 670B y Kimi K2.5, de Moonshot AI, con un billón de parámetros. La empresa informó de una ventaja de eficiencia de 1,9 veces frente a GB200 en GPT-OSS, y de 1,7 y 1,5 veces frente a GB300 en los otros dos modelos. No publicó una comparación entre Jalapeño y GB300 con GPT-OSS 120B.
Las cifras utilizan predicción de un solo token, sin speculative decoding ni prefill-decode disaggregation. En una configuración de varios tokens, la ventaja máxima de eficiencia de Jalapeño frente a GB300 baja aproximadamente a 1,5 veces. Las pruebas usan silicio A0. Ya se fabrica una revisión B0 con aproximadamente un 25 por ciento más de rendimiento por vatio, y está previsto que la producción aumente gradualmente durante 2027.
Comentarios
0Aún no hay comentarios. Escribe el primero.